


更新于 2026年11月21日
从第一天起,Complement 的目标就很简单:让学习更具吸引力、更具互动性、更高效。很快我们就形成了一个信念:拟人化呈现起着关键作用。再好的内容,在屏幕上以不同的方式呈现,产生的影响也不一样。
正因如此,我们一直押注数字人(avatar)。今天,我非常自豪地宣布一次重大升级:全新的照片级写实数字人正式亮相。
为什么我们没有选择 AI 生成视频
近几个月来,AI 视频生成技术取得了令人惊叹的进步。像 Heygen、Synthesia 或 Tavus 这样的厂商,往往只需简单的录制素材,就能生成非常逼真的数字人。
理论上,这非常诱人。但现实中,它并不适合我们的产品:在 Complement,一切都是围绕实时交互设计的。数字人讲话时可以随时打断,可以提问,可以要求换一种说法,而它会立即作答。这种互动性正是整个体验的核心。
然而,AI 生成视频的方案依赖预先计算或繁重的生成流程,目前还无法实现流畅、即时的互动。即便号称“实时”,也无法满足我们对延迟和流畅度的要求。
还有另一个更现实的问题:成本和能耗。生成这类内容需要非常庞大的基础设施,使用 Nvidia H100 或 H200 这类 GPU。成本相当可观,每小时动辄数十欧元,而大规模使用所带来的能耗也很难说得过去。
对于我们的模式而言,提供 AI 视频数字人在经济上不可持续,也与我们打造负责任产品的初衷不符。
真正选择实时
从一开始,我们就做出了一个彻底的选择:实时 3D 数字人。
我们不是从远程服务器推送视频流,而是直接在浏览器中加载 3D 角色文件。加载完成后,它会保留在缓存中。动画同样内置在本地,我们会根据与学员的互动和交流来触发这些动画。
因此,计算在本地完成,由手机、平板或电脑的处理器和图形芯片承担。由于我们对资源做了大量优化,实际负担比想象中轻得多。结果是:本地体验流畅、即时,而且无需服务器费用即可扩展。
到目前为止,我们的数字人一直偏卡通风格。这与我们的技术路线相符,但也限制了沉浸感。
迈向照片级写实,同时不牺牲性能
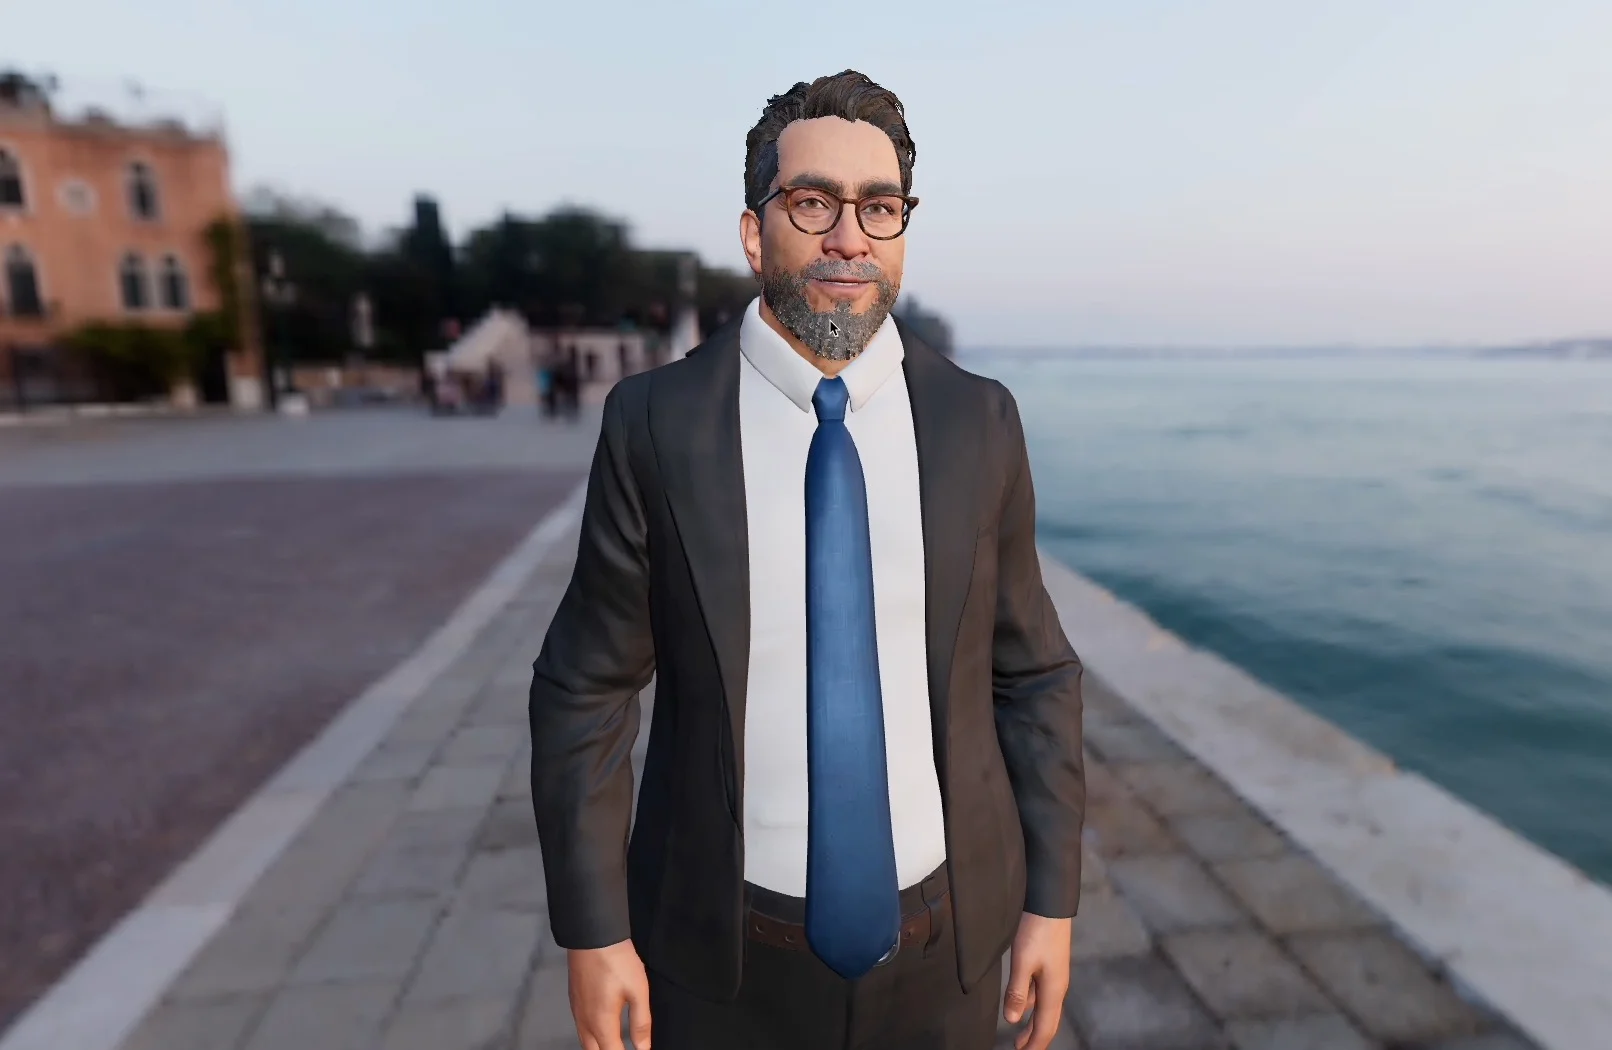
于是我们决定更进一步。为此,我们与一家来自 3D 电影领域的合作伙伴携手,在配备 3D 摄像机的摄影棚中拍摄演员,捕捉他们的表情、手势和表达方式。
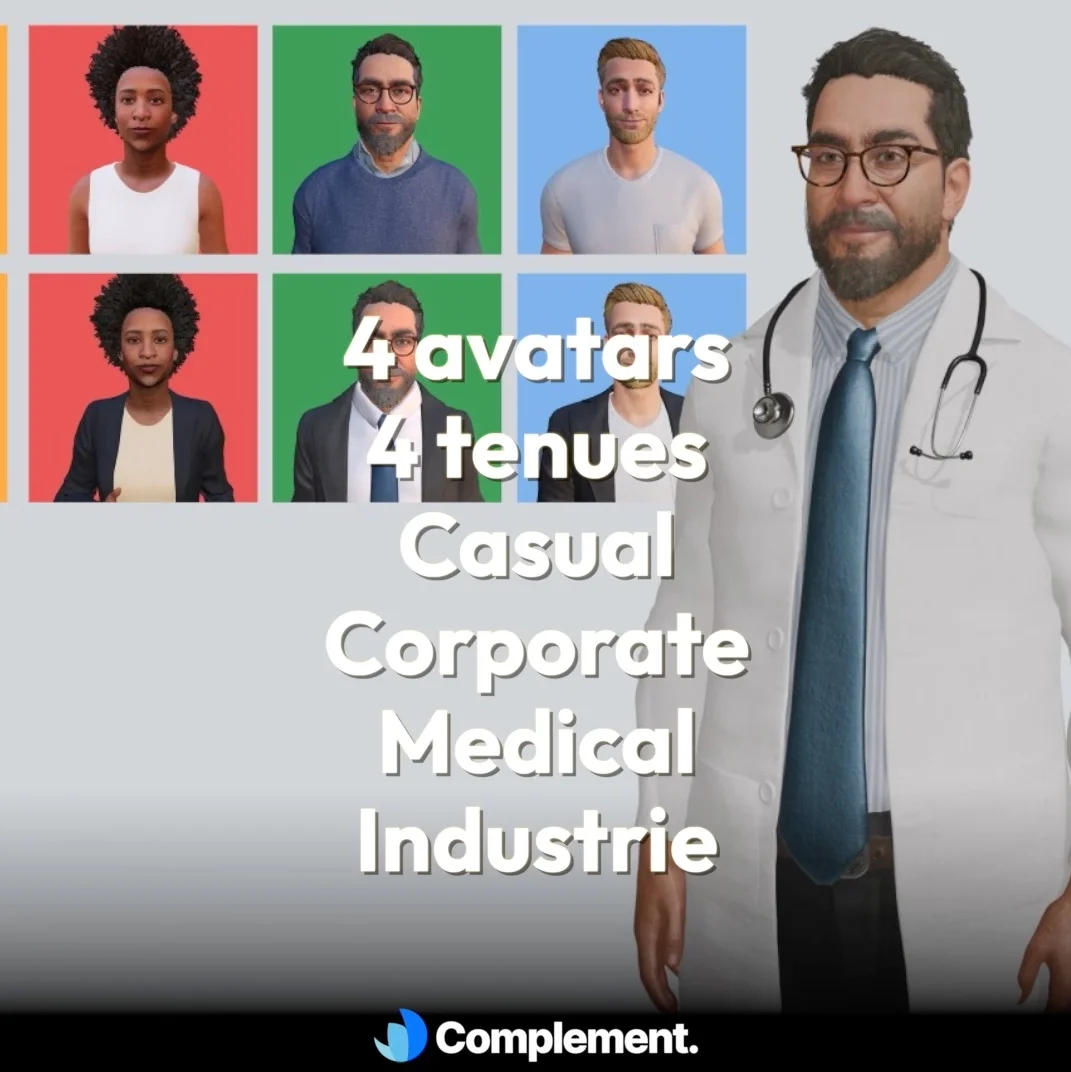
基于这些数据,我们为现有的数字人 Victor、Olivia、Arthur 和 Anna 打造了照片级写实版本。他们保留了各自的身份和特点,视觉可信度则大幅提升。
随后,我们把演员的真实动作映射到这些数字人身上。效果非常明显:动作自然,微表情可信,屏幕上的临场感彻底改变了人们对课程的感受。你不再是在看一个动画角色,而是在与一个真实存在的人互动。
适配各种行业场景的体验
除了写实感之外,我们还希望解决客户一个非常具体的诉求:场景。并非所有培训环境都一样。
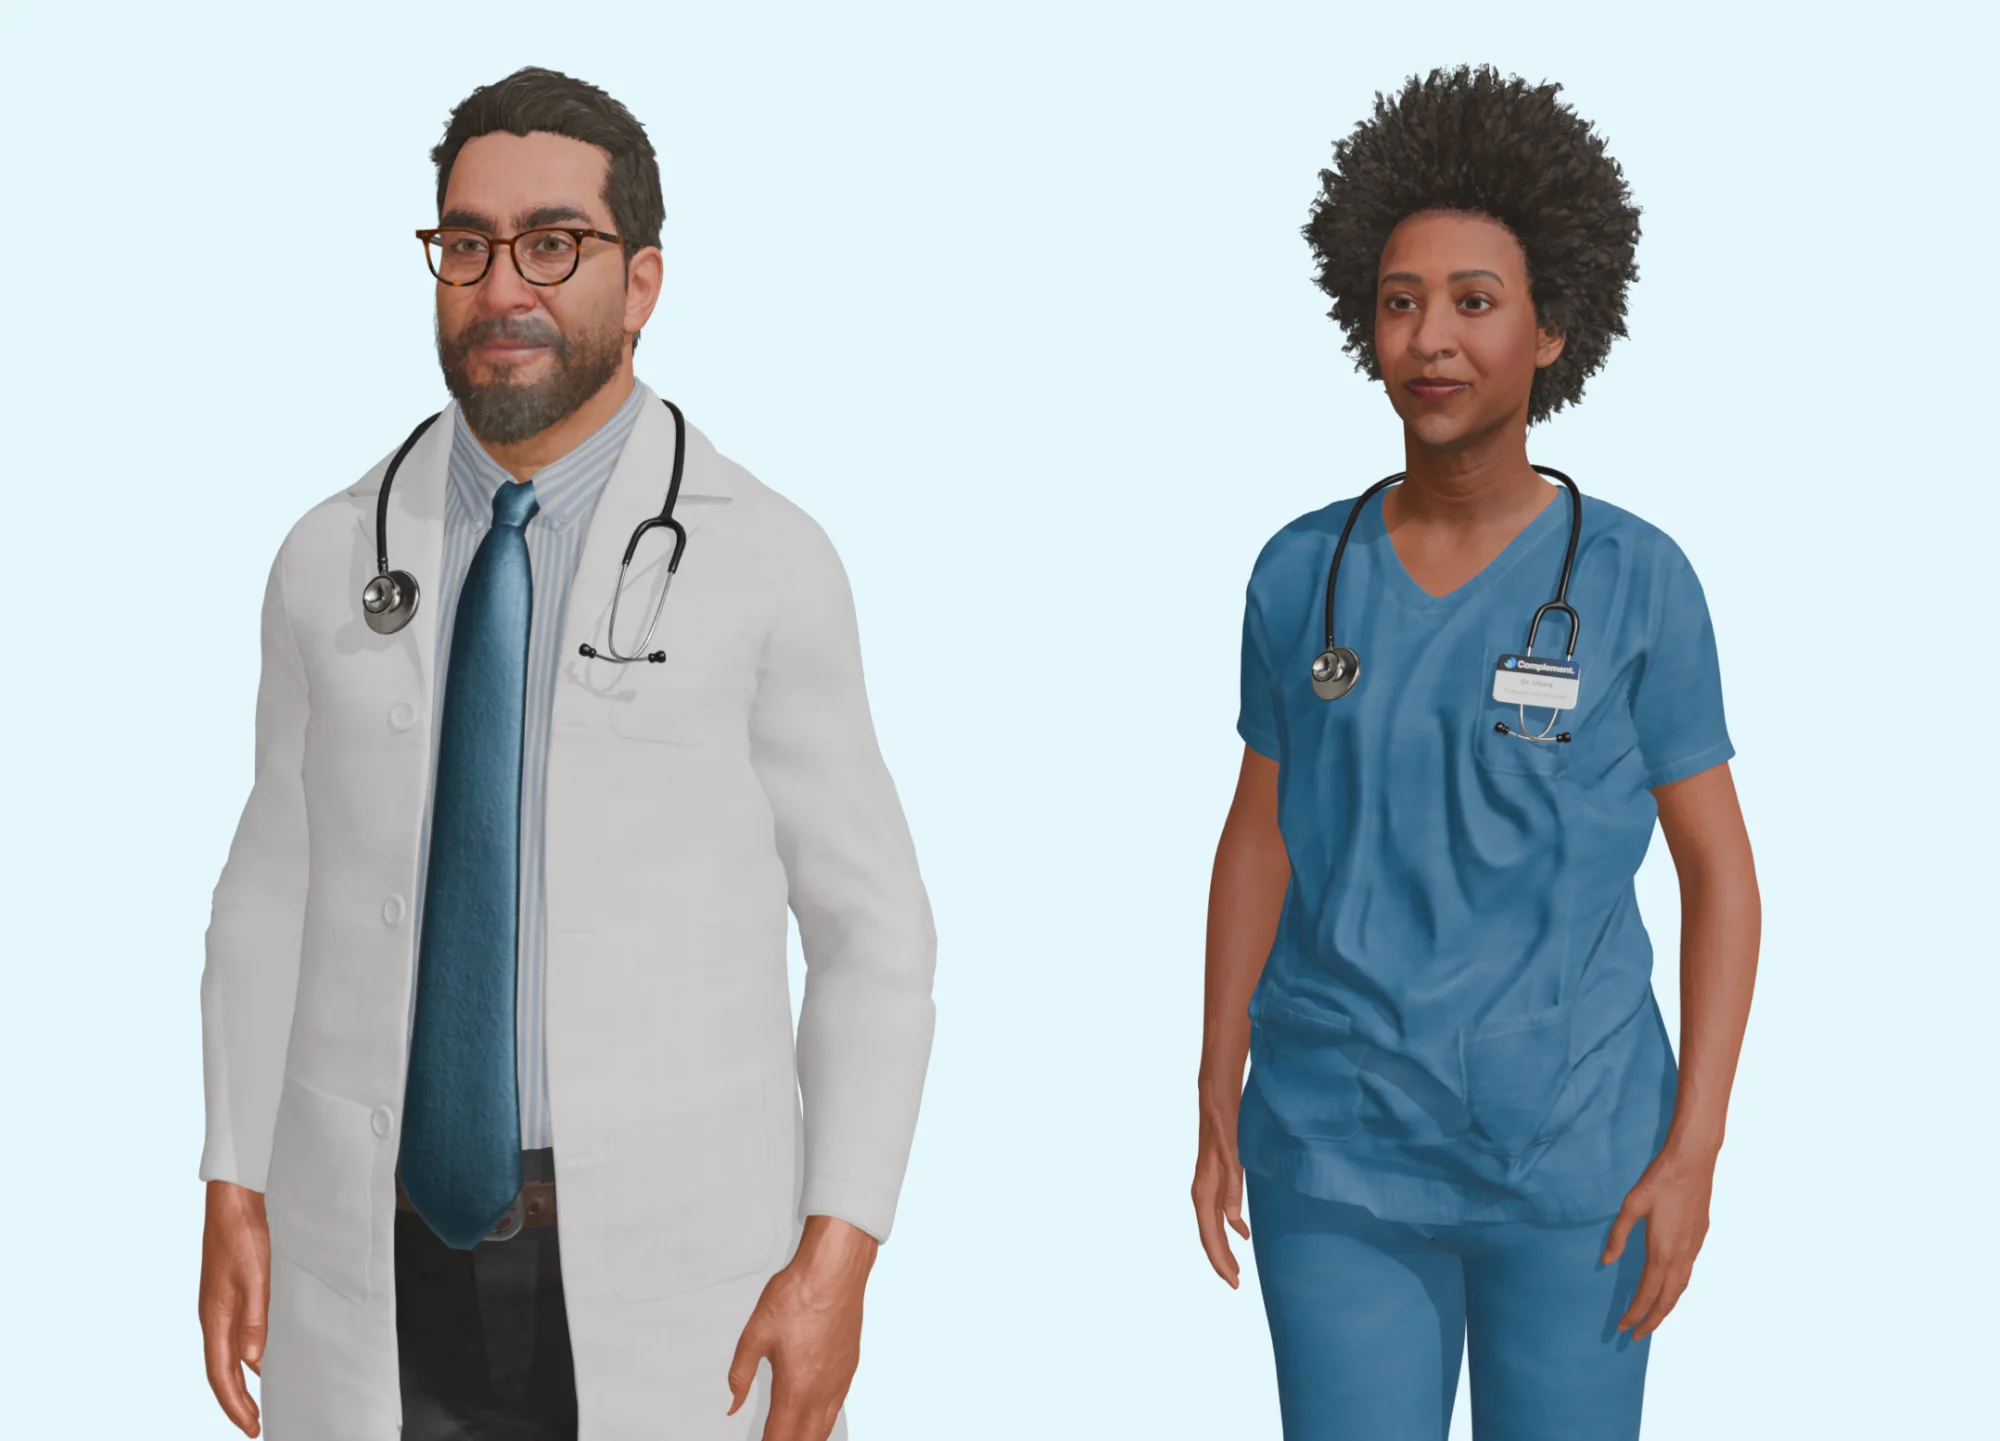
因此,我们现在为数字人提供多种着装:
- 商务着装,适合办公室环境
- “休闲”着装,更适合高等教育、中小企业或培训机构
- 医疗着装,适用于医院和医疗机构
- 一线作业着装,适用于工业、建筑工程和各类操作岗位
这样,客户就能让数字人的外观与自身的行业实际保持一致,进一步增强可信度和参与度。
未来会怎样?
我们相信,基于个人视频由 AI 生成的数字人还会不断进步。当这些技术真正做到“实时”、经济可行且能耗可持续时,将带来极为强大的前景,尤其是讲师可以“克隆”自己的形象,拥有一个数字孪生体。
这是我们密切关注的方向!但眼下,我们的责任是在现实条件下提供尽可能好的体验。
两全其美
借助这一代全新的数字人,我们认为已经找到了平衡点:既有真人拍摄的写实感,又兼具实时技术的性能和互动性。这些新数字人代表了 B2B 和 B2C 软件中实时数字人交流的最佳水平,呈现效果优于 Praktika、Ardoise.ai,甚至 Emma.app。
具体来说,这意味着更高的参与度、更好的专注度,以及对内容更强的沉浸感。而这正是我们从一开始就想要打造的。
这些新数字人现已在 Complement 上线!
如需观看演示并探讨您的 e-learning 项目,请通过以下链接预约时间:https://www.complement.education/rendez-vous