


更新于 2026年11月21日
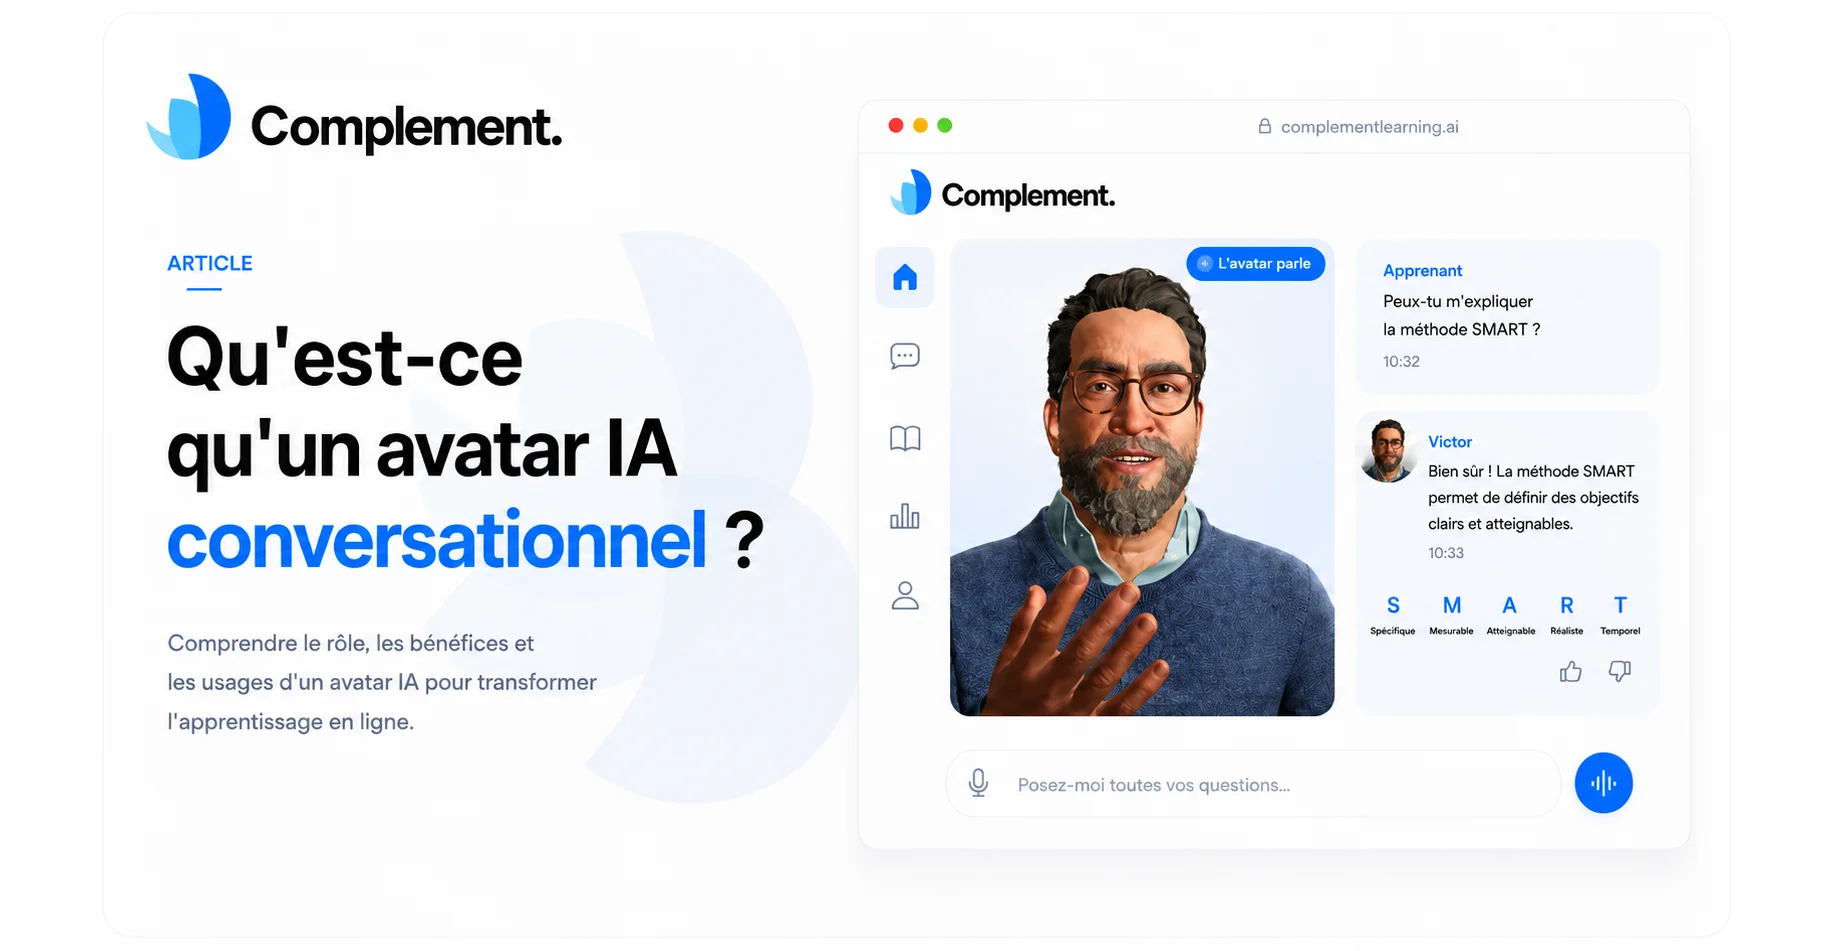
所谓对话式 AI 虚拟形象,简单来说,就是一个可以与之真正交流的虚拟角色。
它通常以自然的 3D 虚拟形象呈现,吐字流畅,动作与语音同步。
因此,它不只是照本宣科地念一段文字,或是出现在一段视频里。它能够倾听问题、理解问题,并直接回应面前的人,整个交流十分自然。
在培训中,这意味着可以拥有一位虚拟讲师:它能够讲解主题、回答学员的问题,还能对学员的回答做出反应。
不过,要真正理解这带来了哪些改变,首先需要分清几个容易混淆的术语。
虚拟形象、AI 虚拟形象、对话式虚拟形象:有何区别?
虚拟形象只是某个人或角色的数字化呈现,可以是电子游戏角色、头像照片,也可以是数字生成的主持人。
AI 虚拟形象则更进一步。例如,人工智能可以生成它的声音和动作,或让它的口型与文本同步。
某些由 AI 生成的视频就是这样:撰写一份脚本,由虚拟形象面对镜头念出来,然后发布视频。
在这种情况下,虚拟形象会说话,但并不会与观看视频的人真正对话。
这正是对话式 AI 虚拟形象的用武之地。
学员可以向它提问,请它重新解释某个内容,或回答它刚刚提出的问题。虚拟形象会根据刚才的对话内容做出反应。
区别其实很简单:对话式虚拟形象不只是说话,它还会交流。
与聊天机器人有何区别?
也许有人会问:为什么不直接使用聊天机器人呢?
从技术上讲,两者可以使用相同的人工智能模型,都能理解问题并给出恰当的回答。
真正不同的是用户与 AI 互动的方式。
聊天机器人通常是一个用来提问的空间:输入一条消息,它给出回答,之后还可以继续讨论。
而对话式虚拟形象在体验中可以更加主动。
例如在培训中,它可以:
- 口头介绍课程;
- 主动提出问题;
- 倾听学员的回答;
- 在学员没有理解某个概念时予以解答;
- 给予反馈;
- 然后自然地继续培训。
这样一来,人们不再只是向 AI 寻求答案,而是与 AI 一起完成培训。
Complement 的 AI 虚拟形象是什么样的?
这正是我们在 Complement 使用虚拟形象的方式。
我们的想法不只是给人工智能加上一张脸,而是让虚拟形象直接参与培训。
举一个很简单的例子:一名学员正在学习 RGPD 培训课程,虚拟形象向他讲解数据可携带权的原理。
这时,学员可以打断它并问:
“我不太明白它和访问权有什么区别。”
虚拟形象随即直接作答,重新解释,然后继续培训。
不过,对话也可以反过来进行。
几分钟后,虚拟形象可能会问:
“你能用自己的话解释一下数据可携带权能做什么吗?”
学员根据所选的形式,以口头或书面方式作答。
随后,虚拟形象会分析他的回答。如果漏掉了重要内容,它可以指出来并补充说明;如果回答正确,它会先予以确认,再继续往下进行。
因此在 Complement,虚拟形象集多种角色于一身:它负责讲解、提问、倾听、回答并给予反馈。
我们的目标还在于让交流尽可能自然。虚拟形象拥有逼真的面孔和声音,吐字经过精心设计,更接近真实对话,而不是机械地朗读脚本。
这对培训意味着什么?
最主要的变化其实很简单。
在传统的视频或 e-learning 模块中,即使学员没有听懂,内容也会继续播放。
有了对话式虚拟形象,学员就可以随时介入。
他可以要求再举一个例子、请它解释某个术语,或提出一个在制作课程时未必预料到的问题。
虚拟形象也可以定期检查学员是否理解。
因此,两个人学习同一门培训课程,所进行的对话未必完全相同。此外,由于学员的参与和主动记忆,信息的留存效果通常要好得多。
这或许就是定义应用于培训的对话式 AI 虚拟形象的最佳方式:一位能够讲解内容的虚拟讲师,更重要的是,它能在每位学员学习的过程中与其互动。
想更详细地了解这项技术的可能性,请阅读我们的专题文章:AI 虚拟形象 vs 传统 e-learning 视频。
想看看 Complement 的虚拟形象如何与学员真正交流吗?预约演示