


更新於 2026年11月21日
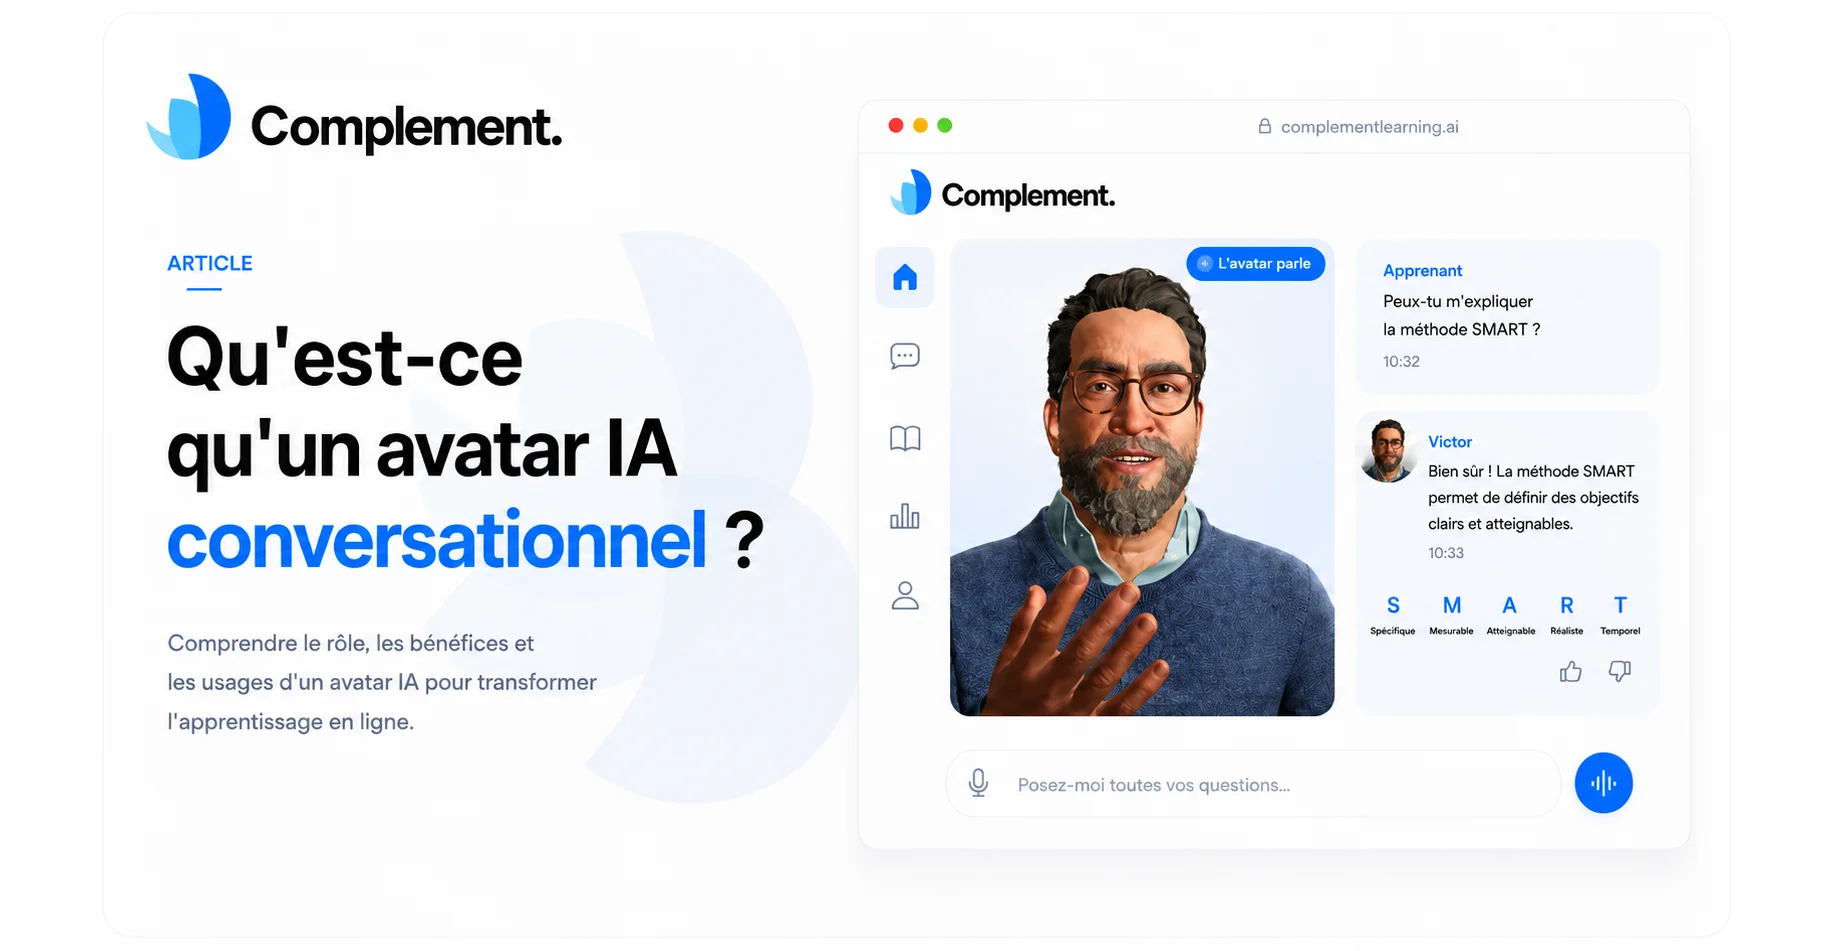
所謂對話式 AI 虛擬人,簡單來說,就是一個可以真正與人交談的虛擬角色。
它通常以自然的 3D 虛擬人形象呈現,咬字流暢,動作與語音同步。
因此,它不只是照本宣科地念一段文字,或是出現在影片中而已。它能聆聽問題、理解問題,並直接回應眼前的對象,進行十分自然的交流。
在培訓中,這意味著可以擁有一位虛擬講師,能夠講解主題、回答學員的提問,甚至針對學員的回答做出反應。
不過,要真正理解它帶來的改變,首先要釐清幾個容易混淆的名詞。
虛擬人、AI 虛擬人、對話式虛擬人:有什麼差別?
虛擬人(avatar virtuel)只是人物或角色的數位化呈現,可以是電玩角色、個人檔案照片,或是以數位方式生成的主持人。
AI 虛擬人,則更進一步。例如,人工智慧可以生成它的聲音與動作,或讓嘴型與文字同步。
這正是某些 AI 生成影片中常見的做法:撰寫腳本,由虛擬人面對鏡頭念出,再發布影片。
在這種情況下,虛擬人會說話,但並不會與觀看影片的人真正對話。
這時就輪到對話式 AI 虛擬人登場了。
學員可以向它提問、請它換個方式重新說明,或回答它剛提出的問題。虛擬人會根據剛才的對話內容做出反應。
差別其實很簡單:對話式虛擬人不只是說話,而是在交流。
與聊天機器人有何不同?
你可能會問:為什麼不直接用聊天機器人就好?
從技術上來說,兩者可以使用相同的人工智慧模型,都能理解問題並給出適切的回答。
真正的差異在於使用者與 AI 互動的方式。
聊天機器人通常是一個讓人前來提問的空間:輸入訊息,它回覆,接著視情況繼續討論。
對話式虛擬人則可以在體驗中扮演更主動的角色。
舉例來說,在培訓中,它可以:
- 以口語方式介紹課程;
- 主動提出問題;
- 聆聽學員的回答;
- 在學員未理解某個概念時加以說明;
- 提供回饋;
- 接著自然地繼續培訓。
因此,我們不再只是向 AI 尋求答案,而是與它一起上課。
Complement 的 AI 虛擬人是什麼樣子?
這正是我們在 Complement 運用虛擬人的方式。
我們的想法不只是為人工智慧加上一張臉,而是讓虛擬人直接參與培訓。
舉個很簡單的例子:一位學員正在上 GDPR 課程,虛擬人向他說明資料可攜權的原則。
此時,學員可以打斷它並問:
「我不太懂這和查閱權有什麼差別。」
虛擬人便能直接回答,重新說明後再繼續課程。
但對話也可以反過來進行。
幾分鐘後,虛擬人可能會問:
「你可以用自己的話說明一下資料可攜權能做什麼嗎?」
學員依所選的形式,以口頭或書面回答。
接著虛擬人會分析他的回答。若漏掉重要內容,它會指出並補充說明;若回答正確,它會先予以確認再繼續。
因此,在 Complement 中,虛擬人身兼多重角色:講解、提問、聆聽、回答並給予回饋。
我們也希望讓交流盡可能自然。虛擬人擁有逼真的臉孔與聲音,咬字經過設計,更接近真實對話,而非機械式地朗讀腳本。
這為培訓帶來哪些改變?
最主要的改變其實很簡單。
在傳統的影片或 e-learning 模組中,即使學員有地方沒聽懂,內容仍會繼續播放。
有了對話式虛擬人,學員就能隨時介入。
他可以要求再舉一個例子、請對方釐清某個術語,或提出製作課程時未必預料到的問題。
虛擬人也能定期確認學員理解了多少。
因此,兩個人上同一門課程,對話內容卻未必完全相同。此外,由於學員主動參與並積極回想,資訊的記憶保留效果通常也好得多。
這或許就是定義應用於培訓的對話式 AI 虛擬人的最佳方式:一位能夠講解內容的虛擬講師,更重要的是能在每位學員學習的同時與其互動。
想進一步了解這項技術的可能性,請閱讀我們的專文:AI 虛擬人 vs 傳統 e-learning 影片。
想看看 Complement 的虛擬人如何與學員真正交流嗎?預約示範